CoreWeave Vera Rubin... Latest News
据 StorageReview 2026 年 10 月 2 日报道,CoreWeave 在其 Fully Connected 2026 旧金山大会上宣布,NVIDIA Vera Rubin NVL72 集群已正式投入生产。AI 代理公司 Cognition 成为首个在该架构上运行实时工作负载的客户。Cognition 工程师报告称,在 SWE-2 推理基准测试中,每 GPU 的 token 总吞吐量比 GB200 NVL72 基线高出 4.8 倍;在强化学习场景中,输出 token 吞吐量提升 3.8 倍。这些数据来自 Cognition 在 CoreWeave Cloud 上运行的生产级代理工作负载,未披露模型规模、上下文长度或批处理配置。CoreWeave 表示,该集群于 9 月初搭建,交付机架后数天内即运行起 Cognition 的工作负载。
权威发布Vera Rubin NVL72 正式上线并开启限量供应
CoreWeave 新闻稿确认 Vera Rubin NVL72 现已可用,但其官方博客将 Cognition 的部署称为“限量供应”,暗示当前分配受管控。客户可通过与 GB200/GB300 NVL72 相同的软件和运营模型访问:CoreWeave Kubernetes Service、SUNK、Mission Control、沙箱和无服务器推理。每个机架由 Dell 制造,配备每 GPU 两个 ConnectX-9 SuperNIC。CoreWeave 在 9 月的多机架搭建中已展示其验证流程,本次亮点在于出现了付费客户。Cognition 的工程师表示:“Vera Rubin 让我们在相同 GPU 数量下支持更多并发 Devin 会话,并加速研究迭代。” 他们强调,在 CoreWeave Cloud 上运行的实际工作负载结果优于任何实验室数据。
政策解读| 指标 | GB200 NVL72 基线 | Vera Rubin NVL72(Cognition 实测) | 提升幅度 |
|---|
| --- | --- | --- | --- |
|---|
| SWE-2 推理每 GPU token 吞吐量 | 1x | 4.8x | +380% |
|---|
| 强化学习每 GPU 输出 token 吞吐量 | 1x | 3.8x | +280% |
|---|
| 可同时运行的 Devin 会话数 | 基础值 | 更高(未公开) | 显著增加 |
|---|
NVIDIA Vera CPU 机架:专为代理沙箱密度设计
CoreWeave 将新增基于 NVIDIA Vera CPU 的独立计算层,面向代理工作负载:沙箱执行、强化学习环境、工具调用、代码执行以及 GPU 训练和推理的周边数据处理。单个 Vera 节点配置两块 88 核 Vera CPU,配备 1.5TB RAM、15.36TB 本地 NVMe 和一块 800Gbps 的 BlueField-4 DPU。整机架容纳 128 颗 CPU(共 11,264 核),配合 BlueField-4 DPU 和 Spectrum-X 以太网交换,CoreWeave 表示可支持超过 11,000 个并发隔离环境。CoreWeave 内部测试表明,Vera 上的代理沙箱启动速度是某 x86 CPU 的 3 倍以上。Vera CPU 机架将提供裸金属形态,适用与 GPU 集群相同的按需和现货消费模型。
政策速递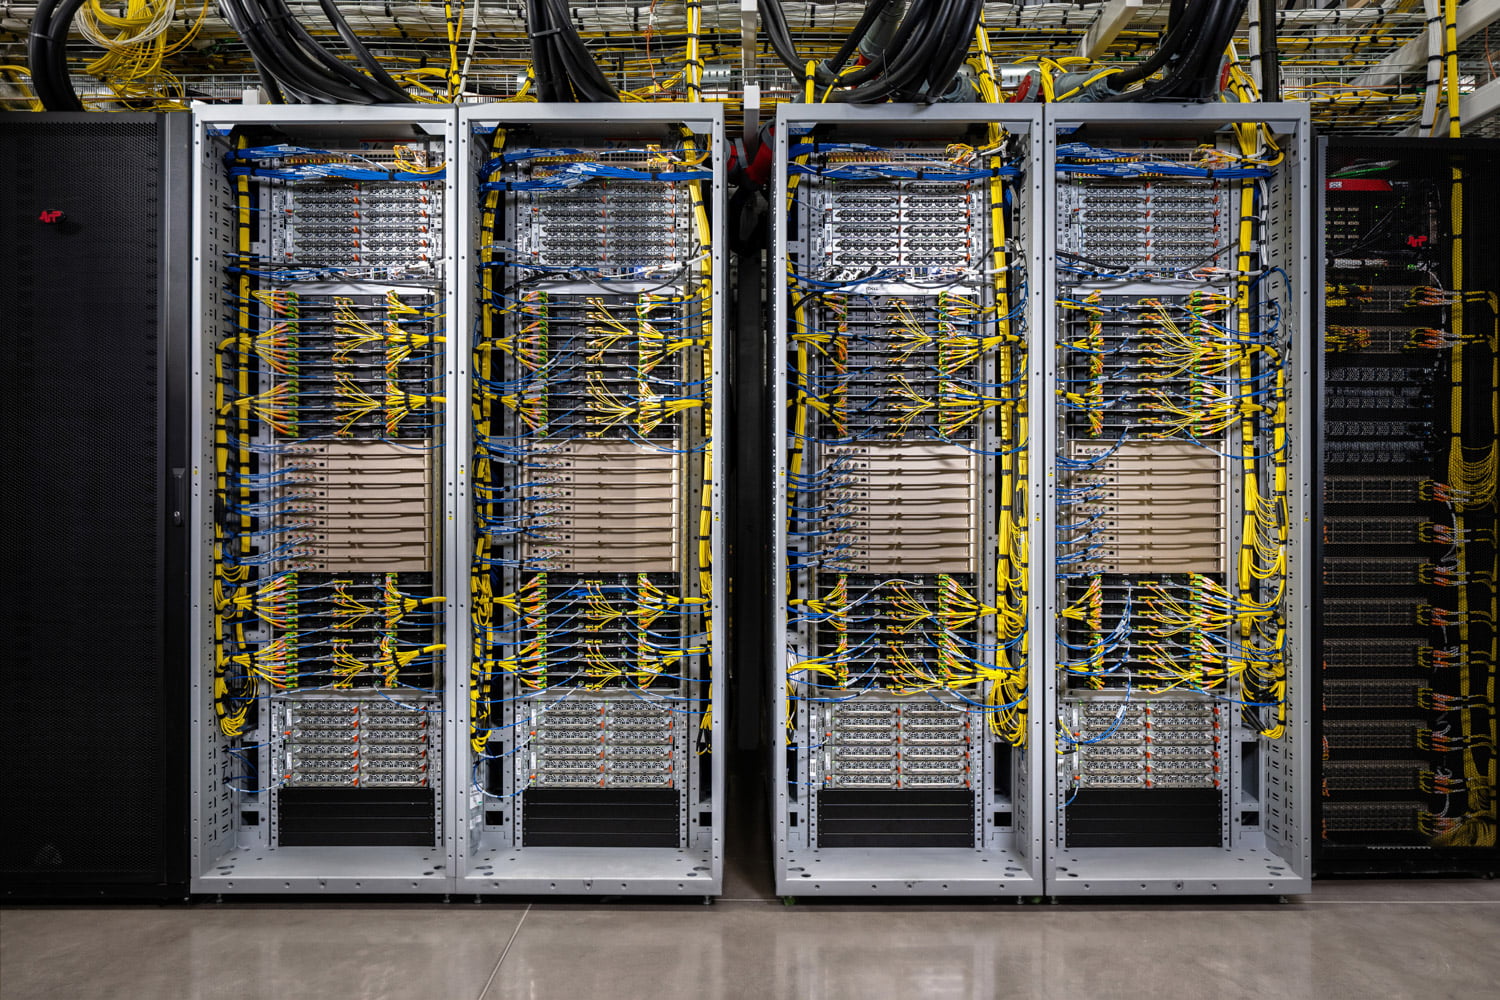
CoreWeave Forge:统一开发与生产平台
CoreWeave 同时推出 Forge 平台,整合了 Weights & Biases Models、OpenPipe 的训后工具和开源 marimo 笔记本项目,形成面向模型和代理的统一开发层。功能涵盖实验跟踪、评估、代理追踪、检查点、沙箱执行、训后微调和推理部署。Forge 支持跨模型、框架和其他云平台。MasterClass 和 Canva 已开始使用。Forge 提供 Free、Pro(月费 60 美元起)和 Enterprise 版本,含 30 天试用。现已面市的功能包括:ARIA、沙箱、Weights & Biases Models、无服务器 SFT、无服务器 RL、Registry、笔记本以及无服务器/专用推理。预览功能包括:Agent Lens、模型蒸馏和 RL Rollouts(允许检查点直接加载到实时部署中,同时训练循环继续运行)。CoreWeave 声称 Agent Lens 可检测到 20% 以上的关键故障,修复成本仅为通用前沿 LLM 的十分之一(博客称一半),无服务器 RL 训练速度提升 1.4 倍且成本降低 40%。
经济形势合作伙伴网络与临床 AI 推理部署
CoreWeave 合作伙伴网络同日上线,包含经生产负载验证的集成方案,涵盖基础设施、数据服务、ISV、安全以及模型推理。合作伙伴包括 CrowdStrike、VAST Data、Reflection、ClickHouse、LanceDB、Inferact、RadixArk、IBM 和 Red Hat。Exa、Parallel Web Systems 和 You.com 通过共享搜索集成加入,用于托管在 CoreWeave 上的代理,未来数周逐步推广。家庭医疗提供商 Ennoble Care 选择 CoreWeave Cloud 进行临床 AI 推理,使用预留的 NVIDIA RTX PRO 6000 Blackwell Server Edition 节点,通过 CKS 实现硬件强制隔离和零信任控制。Ennoble Care 技术总监表示:“CoreWeave 的工程支持团队直接介入,确保我们敏感的病人数据处理符合法规。” CoreWeave 称 CKS 的容器启动速度比某通用云平台快 8-10 倍。
FAQ(常见问题)
Q1: Vera Rubin NVL72 与之前的 GB200 相比,实际性能提升有多少?
A1: Cognition 在生产级代理工作负载上实测,每 GPU token 总吞吐量提升 4.8 倍(SWE-2 推理),强化学习输出吞吐量提升 3.8 倍。这些数据来自真实客户而非理论推算。
Q2: CoreWeave Forge 的定价如何?有哪些核心功能?
A2: Forge 提供免费版、Pro 版(月费 60 美元,含 30 天试用)和企业版。核心功能包括实验跟踪、沙箱、无服务器微调(SFT)和强化学习(RL)、模型注册表以及推理部署。预览功能包含 Agent Lens 和 RL Rollouts。
CoreWeave 通过 Vera Rubin NVL72 的投产证明了其作为 NVIDIA 最新架构首发平台的实力。Cognition 的实测数据验证了该架构在代理推理和强化学习场景的显著优势,而 Vera CPU 机架与 Forge 平台进一步巩固了其面向 AI 工作负载的全栈云能力。随着合作伙伴网络和医疗等垂直行业客户的加入,CoreWeave 正从 GPU 租赁商向一体化 AI 基础设施平台演进。
Related Articles - 明星妆容
CoreWeave 将 NVIDIA Vera Rubin NVL72 投入生产,Cognition 报告每 GPU token 吞吐量达 GB200 的 4.8 倍。Vera CPU 机架、Forge 平台及临床 AI 部署同步推进。阅读深度分析。